Gerald Gmainer10 Min. Lesezeit
RKSV-QR-Code auslesen: Kassabons am Handy mit ML Kit und Parsern
RKSV-QR-Code auslesen, Positionen mit ML Kit und eigenen Parsern erkennen, die Summe prüfen: wie der Beleg-Scanner von MoneyKoi am Handy arbeitet, ohne LLM.
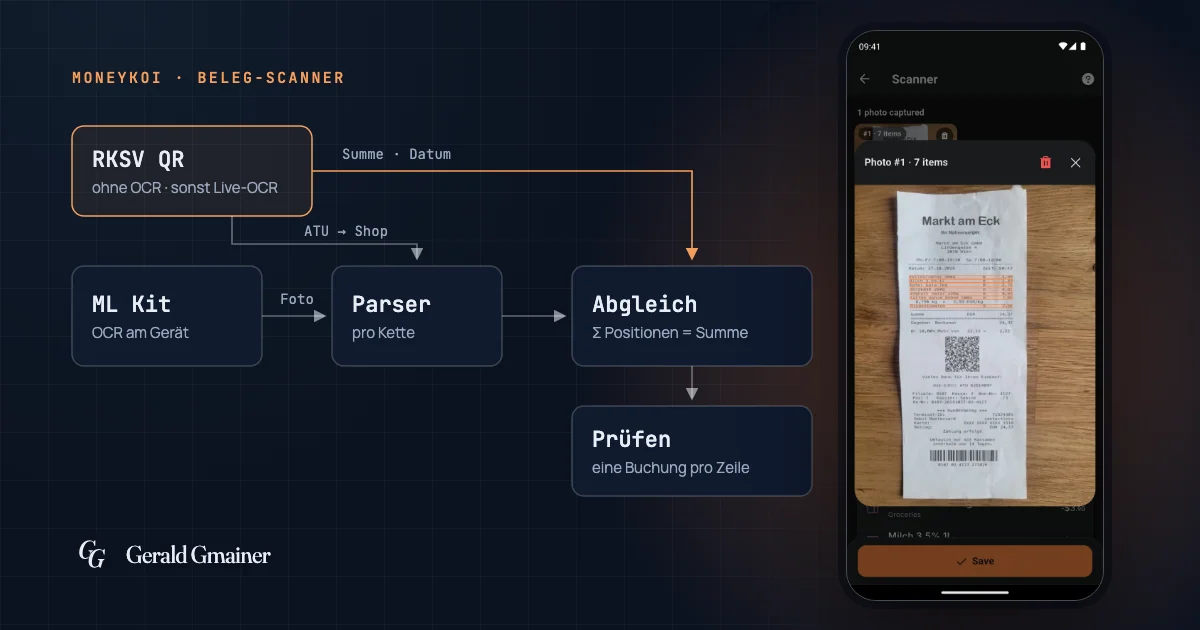
Der Beleg-Scanner von MoneyKoi liest österreichische Kassabons direkt am Handy. Der RKSV-QR-Code liefert Summe und Datum, ohne dass OCR nötig ist. ML Kit erkennt den Text, ein eigener Parser pro Kette liest die Positionen, und ein Abgleich prüft, ob sie die Summe ergeben. Das alles ist regelbasiert, ohne LLM, und das Foto geht an keinen KI-Dienst.
Warum am Gerät und ohne LLM
MoneyKoi ist ein Haushaltsbuch ohne Bank-Login und ohne Cloud-KI (zum Projekt). Der Scanner muss deshalb am Gerät laufen und auch im Flugmodus funktionieren.
Eine Zeit lang gab es in der App einen experimentellen, optionalen KI-Scanner mit einem Sprachmodell, das ebenfalls am Gerät lief (Gemma über LiteRT-LM). Ende September 2026 habe ich ihn wieder entfernt. Geblieben ist der regelbasierte Weg. Sein Vorteil: Jeder Fehler lässt sich auf eine Regel zurückführen, und eine Korrektur bekommt einen Unit-Test, der nach dem Kassabon benannt ist, an dem der Fehler aufgefallen ist.
Der Ablauf hat drei Schritte:
- Summe finden. Die Kamera läuft, OCR sucht Geschäft, Summe und Datum. Ein Feld rastet ein, sobald es sicher genug und in zwei Bildern gleich erkannt wurde. Findet die App einen RKSV-Code, ist dieser Schritt sofort erledigt, ganz ohne OCR.
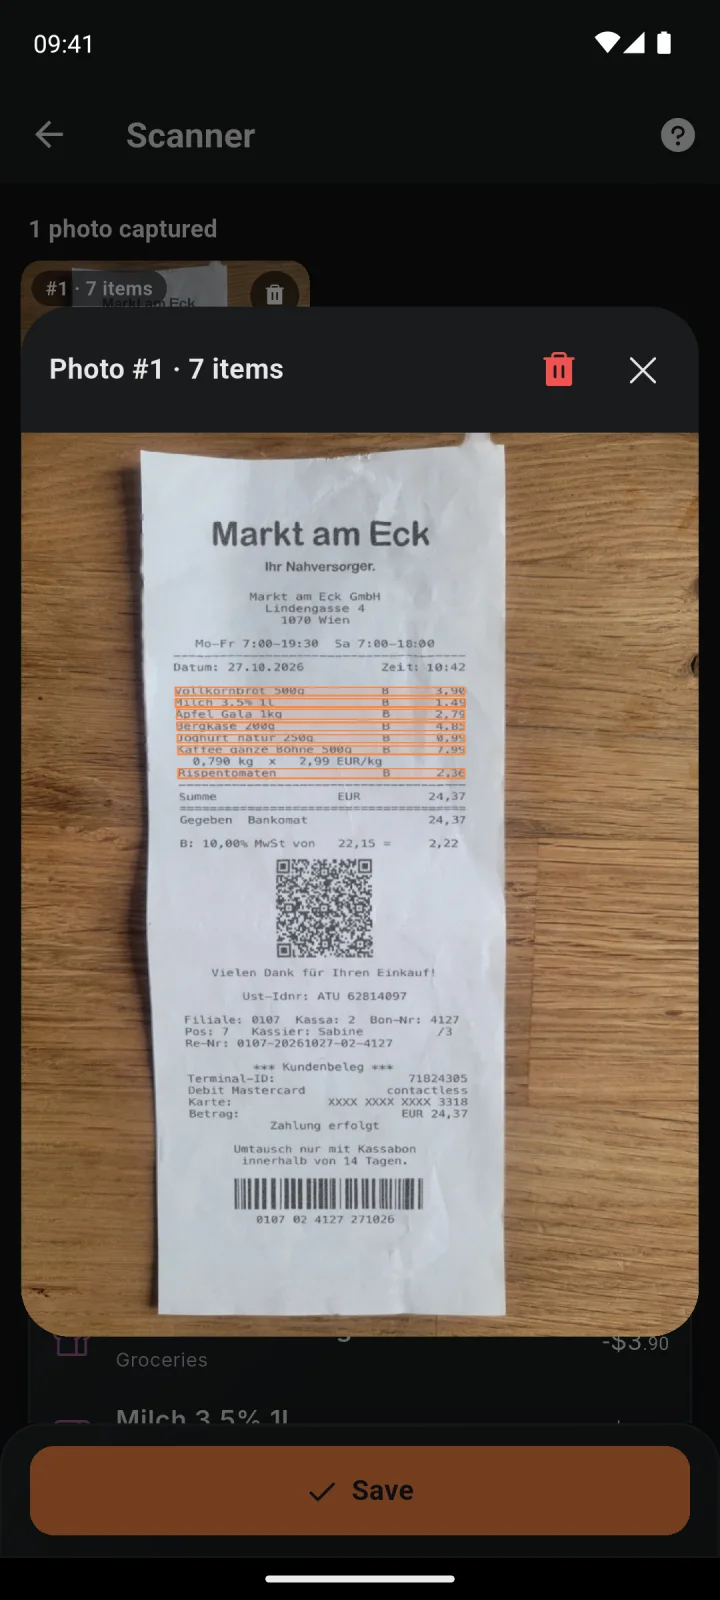
- Positionen erfassen. Der Nutzer fotografiert den Bon, bei langen Bons in mehreren Teilen. Jedes Foto wird mit dem Parser der jeweiligen Kette gelesen, überlappende Zeilen zwischen zwei Fotos werden zusammengeführt.
- Prüfen. Alles erscheint zur Kontrolle, bevor eine Buchung entsteht. Gespeichert wird eine Buchung pro Position.
Den RKSV-QR-Code auslesen
Seit 2017 tragen Belege aus österreichischen Registrierkassen nach der Registrierkassensicherheitsverordnung (RKSV) einen signierten, maschinenlesbaren Code. In meiner Sammlung echter Kassabons ist er praktisch auf jedem: Supermarkt, Franchise-Nahversorger, Diskonter. Für einen Scanner ist er Gold wert, weil er auch dann stimmt, wenn die OCR den gedruckten Text falsch liest. Ganz verlassen kann man sich trotzdem nicht darauf: Bei McDonald's stehen im Code nur Nullbeträge, die Summe kommt dort aus dem Text.
Der Inhalt ist eine Zeichenkette, deren Teile durch Unterstriche getrennt sind (Mustercode und Spezifikation des BMF):
| Teil | Inhalt |
|---|---|
R1-AT0 | Formatkennung |
| Kassen-ID | Kennung der Registrierkasse |
| Belegnummer | fortlaufend pro Kasse |
| Datum und Uhrzeit | z. B. 2026-10-27T10:42:13 |
| fünf Beträge | Bruttobetrag je Steuersatz, z. B. 22,15 |
| Umsatzzähler | verschlüsselt |
| Zertifikats-Seriennummer | oft mit der UID-Nummer des Unternehmens |
| Signatur des Vorbelegs, Signatur | für die Prüfung der Kette |
Die Summe des Bons ist die Summe der fünf Beträge. Ein Geschäftsname steht nicht drin. Vereinfacht sieht der Parser so aus:
final _rksvDate = RegExp(r'^\d{4}-\d{2}-\d{2}T\d{2}:\d{2}');
final _atu = RegExp(r'ATU\d{8}');

RksvData? parseRksv(String payload) {
  final parts = payload.split('_'); // leading '_' gives an empty parts[0]
  if (parts.length < 12 || !parts[1].startsWith('R1-AT')) return null;

  // Find the date instead of trusting a fixed index.
  final d = [3, 4, 5, 6].firstWhere(
    (i) => i < parts.length && _rksvDate.hasMatch(parts[i]),
    orElse: () => -1,
  );
  if (d < 2 || d + 7 >= parts.length) return null;

  final brackets = parts
      .sublist(d + 1, d + 6)
      .map((s) => double.tryParse(s.replaceAll(',', '.')) ?? 0.0);

  final certSerial = parts[d + 7]; // d + 6 is the encrypted turnover counter
  return RksvData(
    date: DateTime.parse(parts[d]),
    total: brackets.fold(0.0, (a, b) => a + b),
    cashRegisterId: parts[d - 2],
    atu: _atu.firstMatch(certSerial)?.group(0),
  );
}
Die Suche nach dem Datum statt eines festen Index ist eine Lehre aus zwei Fehlern. Die erste Version las das Datum aus parts[3] – das ist die Belegnummer – und summierte die Beträge um eins verschoben. Die Summe stimmte trotzdem, zufällig, weil das falsch geparste Datum als 0 zählte. Die zweite Version las die Zertifikatsnummer an der Position des verschlüsselten Umsatzzählers.
Wer hat den Bon ausgestellt
Die Zertifikats-Seriennummer enthält oft die UID-Nummer des Unternehmens (ATU plus acht Ziffern). Fehlt sie dort, liest der Scanner die gedruckte UID-Nummer am Bon. Sie gilt für eine ganze Kette, ist also ein guter Schlüssel. MoneyKoi löst sie in dieser Reihenfolge auf:
- eine fest eingebaute Tabelle mit UID-Nummern großer Ketten,
- gelernte Zuordnungen am Gerät: Zertifikat, UID-Nummer, Kassen-ID,
- eine Abfrage beim EU-Dienst VIES, deren Ergebnis für den nächsten Scan gelernt wird,
- der Geschäftsname aus der OCR.
Die erste Version der Tabelle war aus dem Gedächtnis befüllt. Die Nummern für SPAR, HOFER, LIDL, dm, BIPA und OMV darin lehnte VIES ab, keine davon konnte je auf einem echten Bon stehen. Heute kommt eine Nummer nur in die Tabelle, wenn sie von einem echten Bon, aus dem Impressum oder aus dem Firmenbuch stammt und VIES sie bestätigt. Bei der VIES-Abfrage selbst gab es einen ähnlichen Fehler: Sie schickte nur die acht Ziffern statt U plus Ziffern, und VIES antwortete darauf immer mit „ungültig“. Die dritte Stufe hat also anfangs nie funktioniert.
Franchise-Geschäfte wie ADEG haben die UID-Nummer des jeweiligen Betreibers, nicht die der Kette. Dort hilft nur das Lernen pro Geschäft.
OCR mit ML Kit: aus Textzeilen werden Bonzeilen
ML Kit liefert Textzeilen mit Begrenzungsrahmen, aber keine Tabelle. Der erste Schritt ist deshalb Geometrie: Zeilen, die sich vertikal zu mindestens 55 % überlappen, werden zu einer Bonzeile zusammengefasst. Ein Preis zählt nur, wenn er im rechten Teil des erkannten Texts steht – gemessen an der Breite des Texts, nicht des Fotos, damit ein Bon, der das Bild nicht füllt, trotzdem funktioniert. Ergibt die Gruppierung nicht die Summe, versucht der Scanner es mit 45 % und 65 % erneut und nimmt das Ergebnis, das am nächsten liegt.
Danach wird normalisiert, und hier steckt viel Kleinarbeit:
- Minuszeichen. Bons und OCR liefern Bindestrich, Gedankenstrich, Minus und weitere Varianten. Alles wird vor dem Parsen zu
-. - Dezimaltrennzeichen. BILLA und ADEG drucken auf dem Thermopapier Punkte (
25.21), andere Ketten Kommas. Beides muss gehen. - Zerrissene Preise.
2,9 9und2 ,99werden wieder zu2,99, ohne Mengenangaben oder Jahreszahlen zu verkleben. - Verschobene Spalten. Bei LIDL sitzt die Preisspalte etwa eine halbe Zeile tiefer als die Namen. Ohne Korrektur verrutscht jeder Preis um eine Position.
Ein Parser pro Kette
Eine Registry wählt anhand des Geschäfts einen Parser. SPAR, BILLA, LIDL, ADEG, TEDi, Smyths und OBI haben eigene; HOFER läuft derzeit über den SPAR-Parser, weil ich noch keine HOFER-Bons zum Testen habe. Für alle anderen Geschäfte gibt es einen generischen Parser, der nur mit der Geometrie arbeitet.
Die Ketten unterscheiden sich in Details, die über richtig und falsch entscheiden. Das größte Thema sind Rabatte. Bei SPAR ist Aktionsersparnis 1,00 nur ein Hinweis, der Preis darüber ist schon reduziert. App-Joker 25% -1,25 dagegen wird abgezogen. Weil OCR das Minus gelegentlich verliert, ziehen eindeutige Rabatt-Wörter immer den Betrag ab, egal mit welchem Vorzeichen, nie aber unter null. Ein negativer Betrag ohne Position davor wird verworfen und nie als eigene Position angelegt.
Ein zweites Beispiel ist die Liste der Störwörter, mit der Zeilen der Kartenzahlung herausgefiltert werden. Sie wurde anfangs mit contains geprüft. STAN (eine Autorisierungsnummer) steckt aber in LAUGENSTAN, BAR in BARILLA, und % in jedem Rabatt. Heute gilt eine Wortgrenze:
final _noise = <String, RegExp>{};

bool isShopNoise(String rowText, Iterable<String> keywords) {
  final upper = rowText.toUpperCase();
  return keywords.any((k) => _noise
      .putIfAbsent(k, () => RegExp('\\b${RegExp.escape(k)}\\b'))
      .hasMatch(upper));
}

// isShopNoise('STAN ZAHLUNG', ['STAN']) -> true
// isShopNoise('LAUGENSTAN', ['STAN'])   -> false
Der Abgleich: die Summe muss stimmen
Nach jedem Foto vergleicht ein Reconciler die Summe der Positionen mit der eingerasteten Summe. Stimmt sie nicht, sucht er die eine Korrektur eines einzelnen Preises, die die Summe exakt trifft: eine typische OCR-Verwechslung bei einer Ziffer oder ein verrutschtes Komma (199 → 1,99). Gibt es genau eine solche Korrektur, wird sie angewendet und die Position farbig markiert. Gibt es mehrere oder keine, ändert er nichts, und die Prüfansicht zeigt die Differenz an.
Eine erfundene Position „Fehlende Artikel“, die die Lücke füllt, gibt es bewusst nicht. Nutzer wollten lieber einen sichtbaren Fehler als eine Zeile, die das Problem versteckt.
Noch genauer wird der Abgleich mit der Steuertabelle, die unten auf dem Bon steht. Sie nennt zu jedem Betrag den Steuersatz, und die Positionen tragen bei den meisten Ketten einen Buchstaben für ihren Satz. Damit lässt sich jede Steuergruppe einzeln prüfen: Zwei Fehler in zwei Gruppen heilen beide, und zwei Fehler, die sich in der Gesamtsumme aufheben, fallen trotzdem auf. Die Reihenfolge der fünf Beträge im QR-Code nutzt der Scanner erst, nachdem sie sich auf dem Gerät mindestens dreimal mit einer gedruckten Tabelle gedeckt hat, ohne einen Widerspruch.
Kategorien ohne KI
Jede Position braucht eine Kategorie, und „Sonstiges“ als automatischer Ausweg ist ausgeschlossen. Die Kette der Versuche, leicht vereinfacht:
- Was im Scan selbst gewählt wurde.
- Gelernte Korrekturen am Gerät.
- Eine Schlagwort-Tabelle.
- Die eigenen letzten 300 Buchungen.
- Unscharfe Suche mit einer gewichteten Levenshtein-Distanz, in der typische OCR-Verwechslungen (
0stattO) weniger kosten als andere Fehler. - Ein Lebensmittel-Wörterbuch.
- Der Steuersatz: 10 % heißt bei den Supermärkten Lebensmittel. 20 % bleibt bewusst offen, weil sich Alkohol und Haushaltsartikel diesen Satz teilen.
Gemessen an echten Kassabons
Ohne Messung ist jede Regel ein Bauchgefühl. Deshalb gibt es eine private Sammlung echter Kassabon-Fotos, jeweils mit einer Datei, die das richtige Ergebnis festhält. Ein Testlauf wertet jeden Bon aus und vergleicht pro Kette. Eine Sperre sorgt dafür, dass keine Änderung einen Bon kaputt macht, der vorher funktioniert hat.
Zum schnellen Iterieren läuft die Auswertung auf dem Mac mit Apple Vision statt ML Kit. Dass ein Ersatz nicht das Original ist, habe ich dabei auf die harte Tour gelernt: Vier Runden Regeln für den Kopf des Bons waren auf die Zeilenformen von Vision abgestimmt, und mit ML Kit scheiterte genau dieser Teil öfter. Seitdem gibt es eine zweite Messung mit dem echten ML Kit im Android-Emulator, mit eigener Basislinie. Eine Änderung muss beide bestehen.
Datenschutz
Texterkennung und Barcode-Scan laufen am Gerät, das Foto und sein Text gehen an keinen KI-Dienst. Zwei Ausnahmen gehören erwähnt: Kennt die App die UID-Nummer eines Geschäfts nicht, fragt sie bei VIES nach – übertragen wird nur die Nummer des Unternehmens. Und mit dem Cloud-Plan wird das Foto als Beleg im Buch gespeichert, in der EU.
Grenzen
- Nur lateinische Schrift. Die verwendete Texterkennung liest keine japanischen Bons, obwohl die App Japanisch kann.
- Nur Währungen mit zwei Nachkommastellen. Für ein Buch in Yen oder Forint ist der Scanner gesperrt.
- Deutsche Kassen aus der Spezifikation. Den QR-Code deutscher Kassen (TSE) liest der Scanner, gebaut nach der Spezifikation. An einem echten deutschen Bon getestet ist er noch nicht.
- Lücken in der Abdeckung. Für HOFER und PENNY habe ich keine Test-Bons; HOFER läuft über den SPAR-Parser, und das ist eine Annahme.
- Schlechtes Papier. Verblasste Thermobons und Ziffern, die die Texterkennung verliert, sind die häufigsten Gründe, warum eine Position fehlt oder falsch ist.
Zum Mitnehmen
- Wenn ein Beleg einen signierten Code trägt, ist der die Wahrheit. OCR füllt nur, was der Code nicht enthält.
- Felder in einem Code werden per Muster gefunden, nicht per festem Index.
- Eine Korrektur nur anwenden, wenn sie eindeutig ist. Sonst die Differenz zeigen.
- Stammdaten wie UID-Nummern nie aus dem Gedächtnis eintragen, sondern an der Quelle prüfen.
- Ein Messwerkzeug ist nur so gut wie seine Nähe zur echten Umgebung. Ein Proxy braucht eine zweite Messung mit dem Original.
MoneyKoi gibt es als Android-App bei Google Play. Mehr Infos auf moneykoi.com.
Flutter · ML Kit · OCR